
Você montou uma receita de IA, um interpretador, e precisa decidir qual modelo vai rodar nela. O Benchmark responde com números: coloca vários modelos na mesma prova, com casos reais seus, e mostra quem acertou mais, quem custou menos e quem terminou mais rápido. Ele fica no menu “Otimização” → “Benchmark”.
Esta página é para quem desenha o processo: analista, coordenador, pessoa de negócio. Não precisa saber programar. As animações tocam sozinhas: passe o mouse para pausar e clique para ver de novo. Os números que aparecem nelas são exemplos.
Pense em uma prova aplicada a vários candidatos. A prova é a mesma e as questões são as mesmas. No fim, você compara quem acertou mais, quem custou menos e quem terminou mais rápido.
No Curator, a “prova” é um interpretador: a receita de IA que lê um ofício, extrai um campo ou classifica um documento. Cada candidato é um modelo de IA, como Qwen 3.7 Flash, GPT-5.4 mini, DeepSeek V4 Flash ou Kimi K3. Cada questão é um caso real seu, com a resposta certa já conhecida: o gabarito.
A pergunta prática do Benchmark é: qual modelo eu devo usar nesta receita? Em vez de escolher por opinião ou por moda, você mede na sua própria base de documentos.
Todas as comparações ficam numa tela só. Para chegar lá:
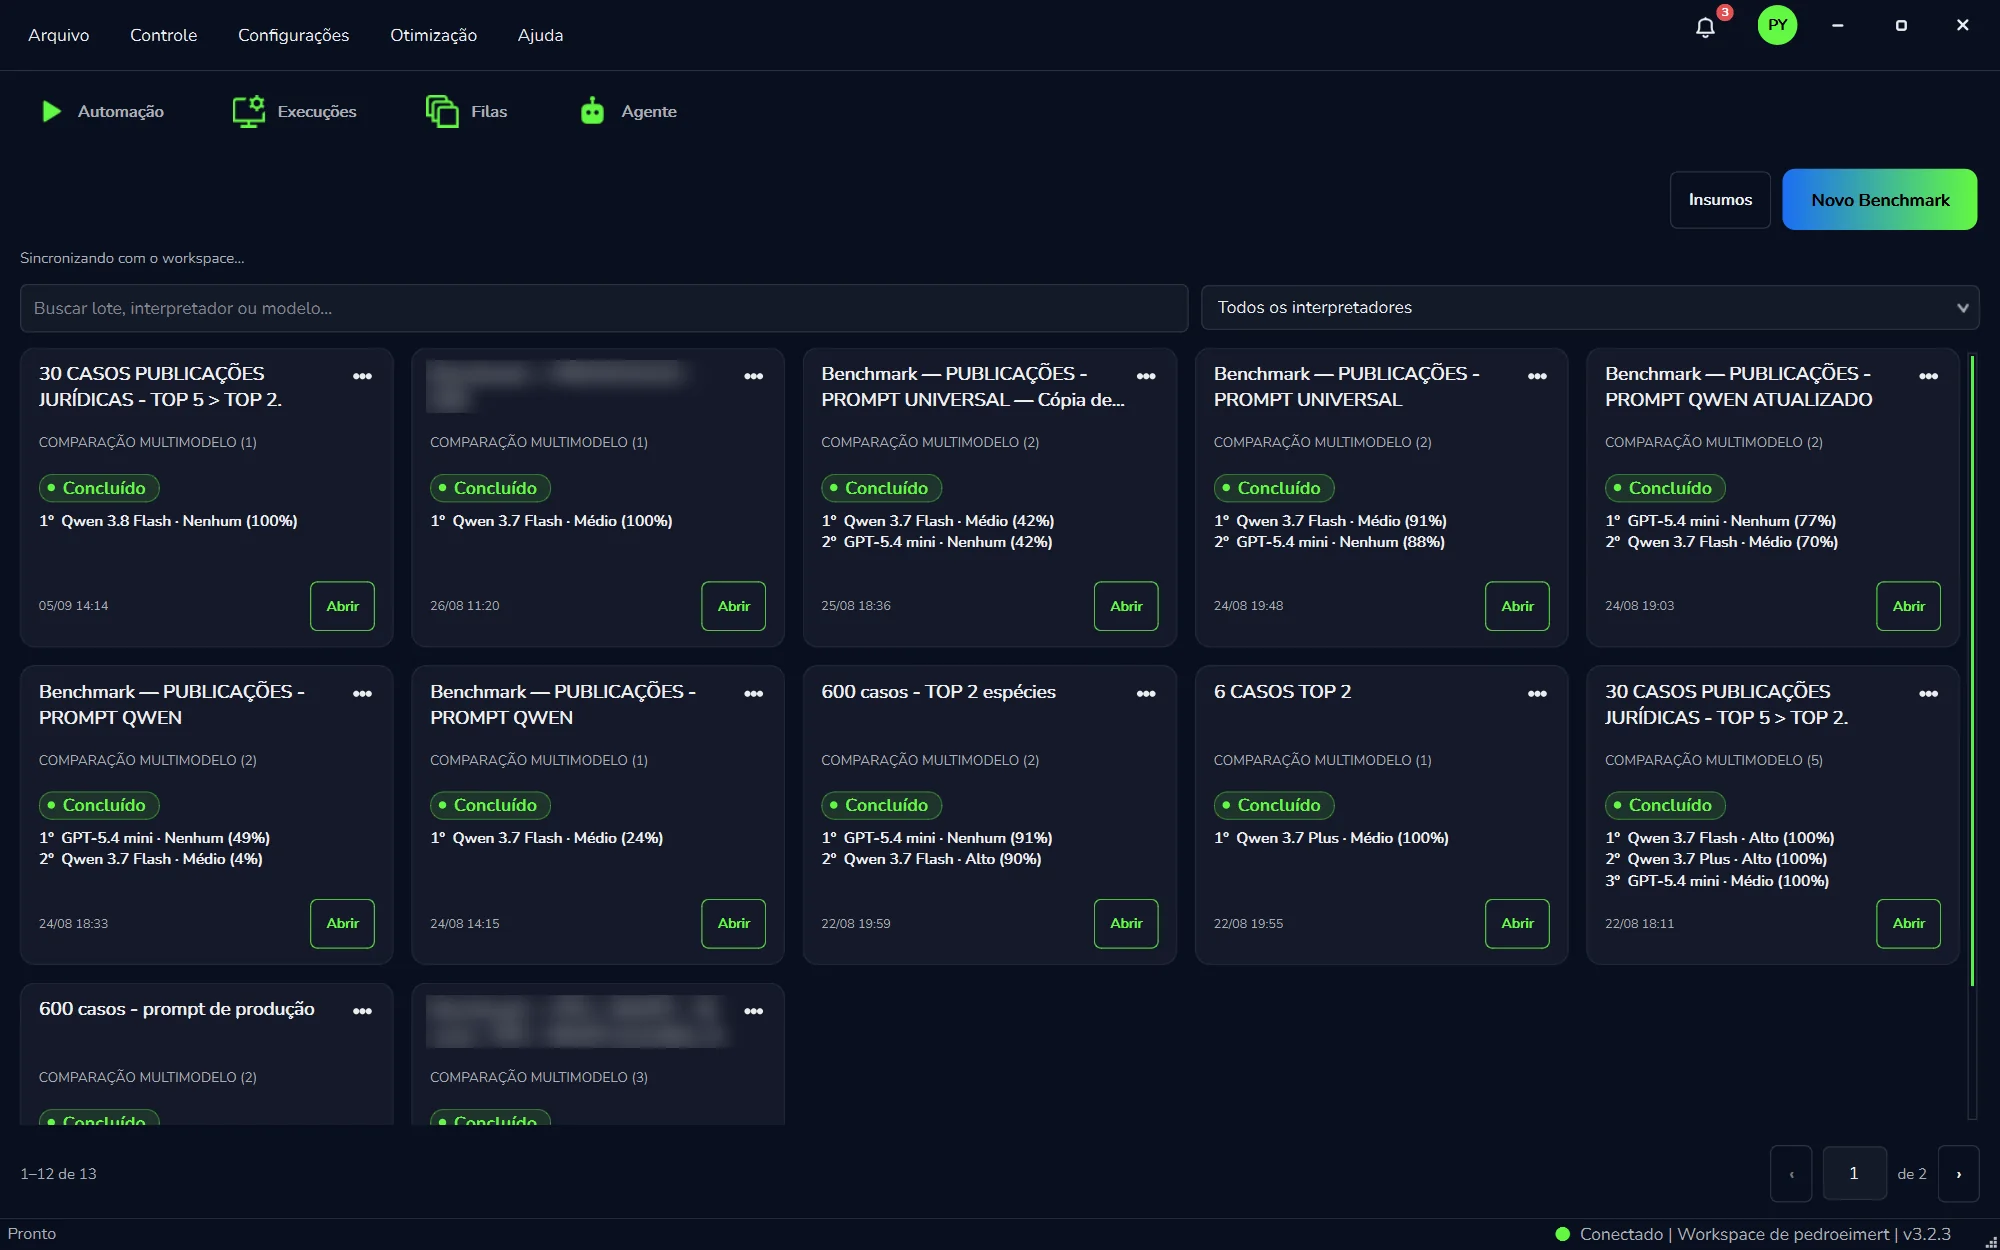
| Na tela | Para que serve |
|---|---|
| “Insumos” | O material das provas. No Curator, insumo é a entrada de cada caso, aquilo que o interpretador lê: o texto do ofício, o PDF. |
| “Novo Benchmark” | O botão em degradê azul e verde. Começa uma comparação nova. Veja O caminho em cinco passos. |
| “Sincronizando com o workspace...” | Aparece enquanto o Curator atualiza a lista com o workspace em que você está, o mesmo que aparece na barra de status, no rodapé da janela. |
| “Buscar lote, interpretador ou modelo...” | Digite parte do nome do lote, da receita ou do modelo, como “Qwen”, para achar uma rodada antiga. |
| “Todos os interpretadores” | O filtro ao lado da busca. Escolha uma receita para ver só as rodadas dela. |
| Rodapé | Com muitas rodadas, a lista vira páginas. “1–12 de 13” diz quais cartões você está vendo, e as setas trocam de página. |
Cada cartão resume uma rodada: qual foi o lote, quantos modelos entraram, se terminou e quem ficou na frente. Os números no recorte correspondem aos itens da lista.
Depois da prova, o Curator mostra três números lado a lado para cada modelo:
| Nota | Em português claro |
|---|---|
| Assertividade | Quantos por cento das respostas bateram com o gabarito que você cadastrou. É o termo da tela em português (em outros produtos você pode ver “acurácia”). É o número entre parênteses no cartão. |
| Custo | Quanto aquele modelo gastaria, em dólares, para processar aquele volume. É uma estimativa calculada pelo Curator para comparar modelos: não substitui a fatura do provedor. |
| Velocidade | Quanto tempo o modelo levou para processar tudo. |
No fim, o Curator monta o ranking. Qualidade primeiro, economia depois: quem acerta mais sobe; se empatar, sobe o mais barato; se ainda empatar, sobe o mais rápido.
Para acompanhar onde a IA foi usada no dia a dia, com o custo calculado por modelo, use a janela “Uso de IA”. Lá vale o mesmo cuidado: “Valores calculados, não uma fatura.”
Use o Benchmark quando a escolha do modelo tem dinheiro ou qualidade em jogo:
Estes nomes aparecem na tela e nos relatórios. Vale conhecer antes de começar:
| Nome no Curator | Em português claro |
|---|---|
| Interpretador | A receita (a prova) que será avaliada, feita de passos encadeados. |
| Passo | Uma etapa da receita, com instrução própria e resposta própria. |
| Lote | O conjunto de casos da prova, com o gabarito de cada um. |
| Caso | Uma questão real: um ofício, um contrato, um documento específico. |
| Insumo | A entrada de um caso, aquilo que o interpretador lê: o texto do ofício, o PDF. |
| Gabarito | A resposta certa esperada naquele passo daquele caso. |
| Obtido | A resposta que a IA realmente devolveu. |
| Comparação multimodelo | Uma rodada do Benchmark: o mesmo lote passado por um ou mais modelos. No cartão, o número entre parênteses diz quantos. |
| Assertividade | O percentual de acerto. Termo oficial da tela em português. |
O lote é a pasta com as questões da prova. Cada caso traz duas coisas: as entradas, que o Curator chama de insumos (o texto do ofício, o PDF, o que o interpretador precisa ler), e o gabarito (a resposta certa em cada passo).
O mesmo lote pode ser reaproveitado com modelos diferentes ou em datas diferentes. É isso que permite comparar resultados ao longo do tempo.
| Tamanho | Para que serve |
|---|---|
| Menos de 10 | Só para testar se a receita funciona, não para decidir o modelo. |
| 20 a 50 | Costuma bastar para comparar modelos em classificação ou extração com confiança razoável. |
| Mais de 100 | Mais confiança, mas também mais tempo e custo: cada caso roda uma vez por modelo. |
O caminho mais seguro é o botão que gera o modelo em Excel. O Curator já cria as colunas certas para aquele interpretador: nome do caso, uma coluna por insumo e uma coluna de gabarito por passo (com o nome do passo).
Depois de escolher o arquivo, a tela de mapeamento liga cada coluna da planilha ao campo certo. As sugestões já vêm preenchidas; você só ajusta o que estiver diferente. No fim, o Curator mostra quantos casos entraram e quantos têm gabarito.
Antes de iniciar, confira três coisas: o interpretador tem pelo menos um passo; o lote tem pelo menos um caso; e cada modelo escolhido tem a chave de API do seu provedor configurada neste computador (veja Chave de API).
Todos os modelos recebem a mesma prova: mesmos casos, mesma ordem, mesmas instruções. Um detalhe importante: durante o benchmark, o modelo em teste faz a receita inteira, mesmo que na produção cada passo use um modelo diferente. É assim que se responde “e se eu usasse só este modelo?”.
Os modelos andam em paralelo: um não espera o outro. Dentro de cada modelo, os casos andam um de cada vez. Dentro de cada caso, os passos vão em cadeia.
A tela mostra em qual caso e em qual passo cada modelo está. Você pode sair: a rodada continua sozinha, e o andamento fica no cartão dela, na tela “Benchmark”. Pausar e parar valem para o modelo selecionado, não para a rodada inteira. É útil quando um modelo está caro ou lento demais.
Uma conta rápida de custo: chamadas ≈ casos × passos × modelos. Exemplo: 50 casos × 3 passos × 4 modelos = 600 chamadas.
A assertividade é: passos corretos ÷ passos com gabarito × 100. Passos sem gabarito ficam fora da conta. Na rodada aberta você vê algo como “90% (135/150 passos)”.
A correção automática ignora maiúsculas e espaços extras. O que ela não faz: julgar se dois textos têm o mesmo sentido. “TJSP” e “Tribunal de Justiça de São Paulo” são textos diferentes, e a correção automática marca como errado.
Ordem do ranking: (1) maior assertividade; (2) menor custo; (3) menor tempo. Modelos que falharam ficam no fim. Os gráficos mostram acerto, custo e velocidade por modelo: barra maior é melhor no gráfico de assertividade; barra menor é melhor em custo e tempo.
Se o lote foi criado com revisão manual, a rodada termina em “Aguardando revisão”. A assertividade só fica definida depois que você marca cada passo como certo ou errado.
A tela mostra o esperado, o obtido e a entrada do caso. Você marca e, se quiser, anota o motivo, o que ajuda a diagnosticar depois. A marcação humana prevalece. Mesmo em lotes manuais, a correção automática pode pré-marcar; você confirma ou corrige.
O Excel da rodada tem três abas:
As rodadas ficam na tela “Benchmark”, em cartões, e a busca acha qualquer uma pelo lote, pelo interpretador ou pelo modelo. Para auditoria de longo prazo, exporte o Excel. O número sozinho não decide: use o ranking para organizar, o Excel para entender os erros e o custo de um erro no seu processo para escolher o modelo de produção.
Escolheu o modelo? Volte à receita em Interpretadores e ajuste o modelo de cada passo.